精选
免费旅游规划助手
日常效率
123 次下载查看技能
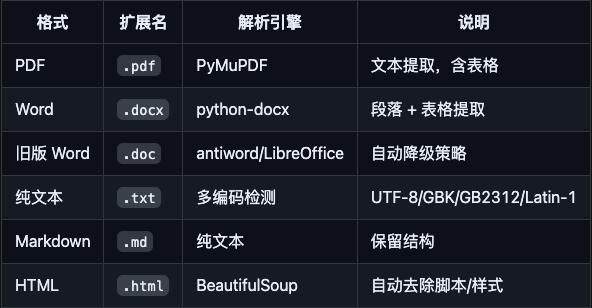
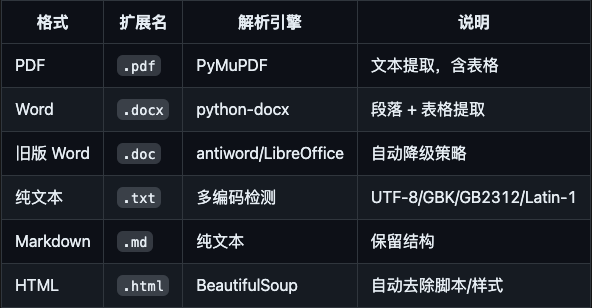
当用户提出以下意图时触发本技能:
上传/导入文档并构建知识库 对已有文档进行提问、检索、摘要 管理知识库(查看文档列表、删除文档、清空) 使用自然语言描述文档处理需求(如"帮我把这些论文整理成知识库") 核心能力
文本分块策略(递归切分,三层降级): 按段落切分(优先保持语义完整性) 段落过长时按句子切分(中英文句号/问号/叹号) 句子仍超长时按固定长度切分(含 overlap 重叠,默认 512 字符 / 128 重叠) 文本清洗: 多余空白合并 → 控制字符移除 → 连续空行压缩 → 页码格式移除
Embedding 模型: BAAI/bge-large-zh-v1.5(1024 维,中文语义优化) 向量数据库: FAISS(IndexFlatIP + IndexIDMap,支持余弦相似度与文档删除) 检索策略: L2 归一化 → 内积相似度 → Top-K 过滤 → 相似度阈值截断(默认 0.7)
默认模型: Qwen/Qwen2.5-7B-Instruct OpenVINO 加速: 支持 CPU/GPU/NPU 自动选择(优先级 NPU > GPU > CPU) INT8 量化: 默认启用,7B 模型显存从 ~14GB 降至 ~7GB 模型缓存: 首次转换后持久化存储,后续直接加载
提供四种查询模式:
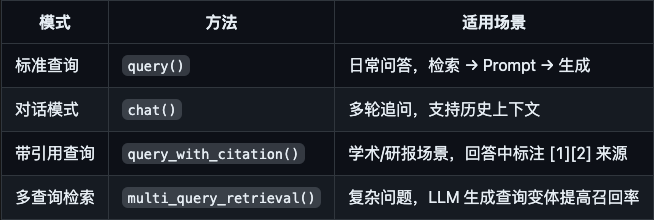
Agent 工作流程 当用户上传文档或提出知识库相关请求时,按以下流程执行:
阶段一:文档导入 用户上传文档 → DocumentProcessor.process() 解析 + 分块 → EmbeddingEngine.encode() 向量化(批量处理,默认 batch_size=32) → VectorStore.add() 写入 FAISS 索引 + 持久化 → 返回处理结果(成功/失败文档列表 + 总分块数) Agent 操作指引:
收到文件后立即调用 adddocuments(),不等待用户确认 若文件格式不支持,明确告知用户并列出支持格式 处理完成后汇报结果:成功 N 个文档,共 M 个文本块 阶段二:知识检索 用户提问 → EmbeddingEngine.encode([query]) 查询向量化 → VectorStore.search() Top-K 检索 + 阈值过滤 → RAGPipeline.build_context() 构建上下文 → LLMEngine.generate() 生成回答 → 返回 { answer, sources, citations } Agent 操作指引:
标准问题使用 query(),学术/严谨场景使用 querywithcitation() 回答时展示来源文档信息 若检索结果低于阈值,诚实告知"知识库中未找到相关信息" 阶段三:知识库管理 Agent 操作指引:
listdocuments() → 以表格形式展示文档列表 deletedocument(id) → 删除前需用户确认 clearknowledgebase() → 危险操作,必须二次确认 get_stats() → 展示文档数、分块数、模型信息等统计