图像故事视频向导
效果展示
使用方法
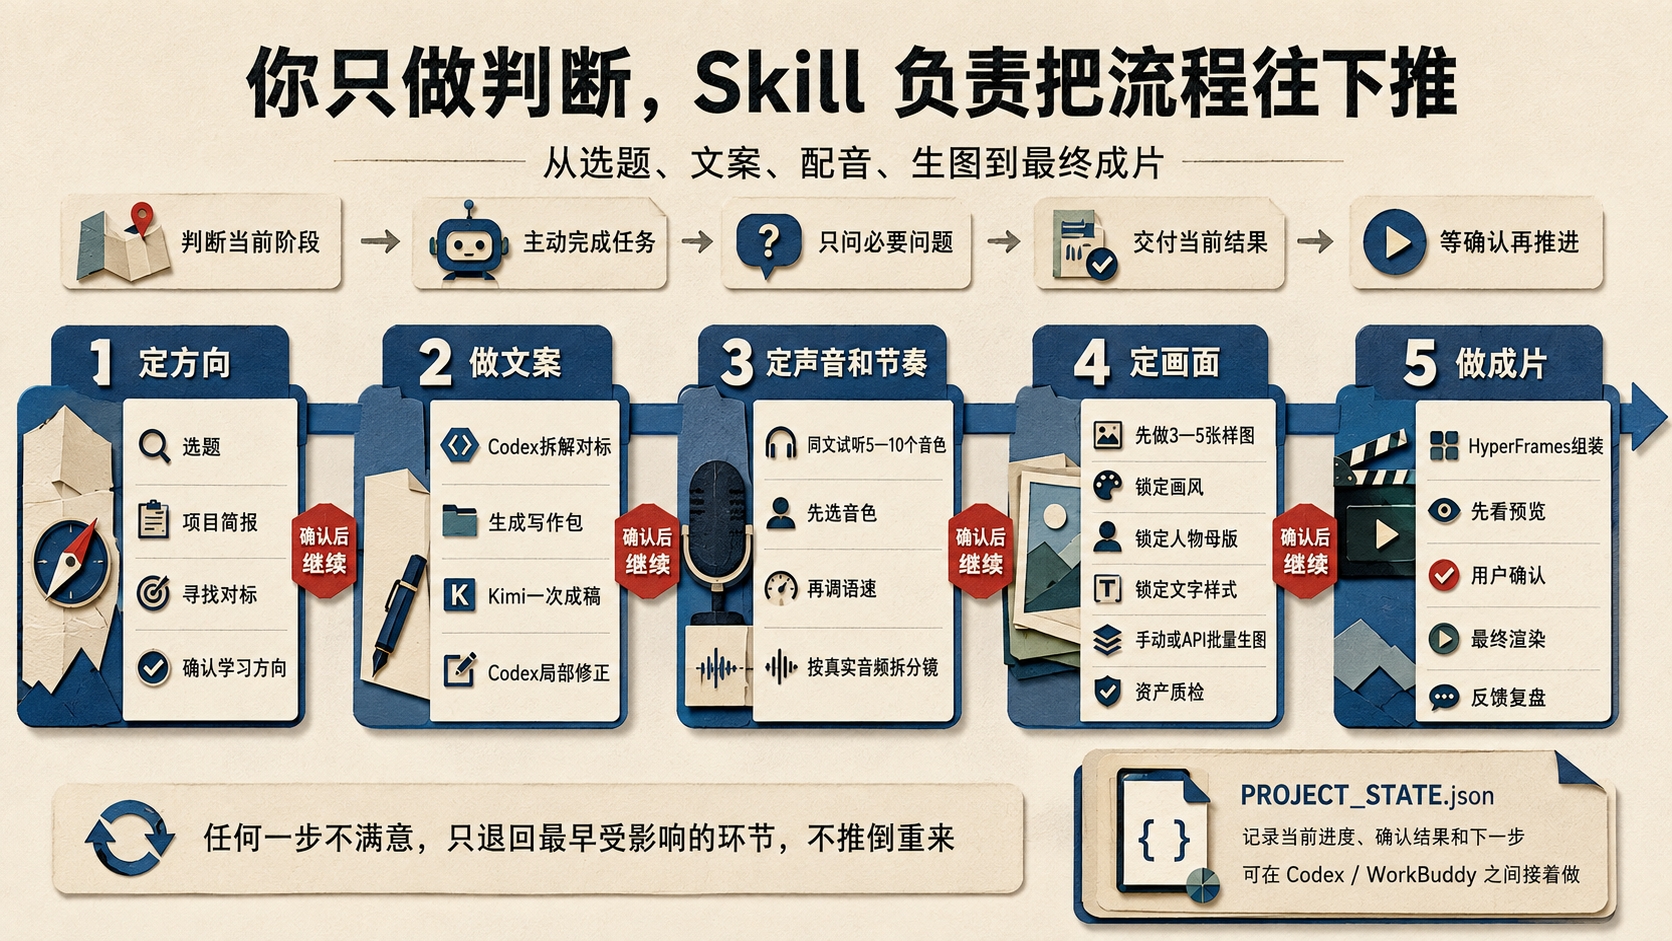
它的核心不是把一整套流程一次性丢给用户,而是主动引导和推进:Skill 判断当前阶段、完成能自己做的工作,用户只在关键节点提供材料或做确认。
它怎么带你往下做 每一轮都会说清楚五件事:
现在进行到: 我现在会做: 你现在只需要: 完成后我会交付: 确认后下一步: 完整阶段是:
START → BRIEF → BENCHMARKS → WRITINGPACK → SCRIPT → VOICE → STORYBOARD → VISUALSTYLE → CHARACTERANCHORS → IMAGEPROMPTS → IMAGEGENERATION → ASSETQC → MUSIC → PREVIEW → FINAL_RENDER → FEEDBACK
关键确认点包括:
对标方向没确认,不做写作包。 文案没定稿,不生成完整配音。 画风、文字风格和样图没确认,不批量生图。 预览没通过,不渲染最终成片。 某一步失败时,只回到最早受影响的阶段,不会把整个项目推倒重来。 适合的项目 AI 讲书、历史故事、情感故事和有声故事。 播客音频加配图的图片联播视频。 需要人物一致性、固定画风、字幕和文字卡的静态图叙事视频。 如果你只需要一篇文案、一张图或普通剪辑,不需要调用这个 Skill。
开始使用 直接对 Codex 或 WorkBuddy 说:
我想做一期【选题】的图片联播视频,请使用 image-story-video-wizard 带我从现在的阶段往下做。你主动推进,每次只让我提供当前必需的材料或做当前确认。
项目会用 PROJECT_STATE.json 记录当前阶段、已确认决定、产物路径和下一个需要用户回答的问题。换到另一个宿主后,可以从这个状态继续。
教程中的默认路线 长文案:先用 Codex 完成对标学习和写作包,再交给 WorkBuddy 中的 Kimi K3。当页面确实提供时,选择 Max 模式、最高思考强度和 1M 上下文。 配音:使用当前的豆包 Seed-TTS 2.0,先用同一段约 20 秒的文字测 5–10 个音色,确认音色后再调语速。 生图:先做 3–5 张样图,然后锁画风、人物母版和文字样式。手动路线默认一个新对话只跑一条提示词、生成一张图。 剪辑:素材齐全后优先使用 HyperFrames 组装,先看预览,确认后再渲染最终成片。